开场:三个助手,一个人的项目经理日常
假设你电脑上跑着三个 AI 助手:一个画图的,一个查资料的,一个写代码的。
现在来了个活,需要三个人配合:画图的出一张产品矩阵图,查资料的把那几个产品的定价和用户量找出来,写代码的把数据接进落地页,最后汇总成一份能给投资人看的材料。
你把这个活交给其中一个助手,希望它去协调另外两个。实际发生的,通常是这几件事。
配置这关先卡住。跨 agent 派活在 OpenClaw 里要过两层门:会话可见性和授权白名单。白名单还是双向的,发送方和接收方都得在里面,少配一边就报「不允许」。
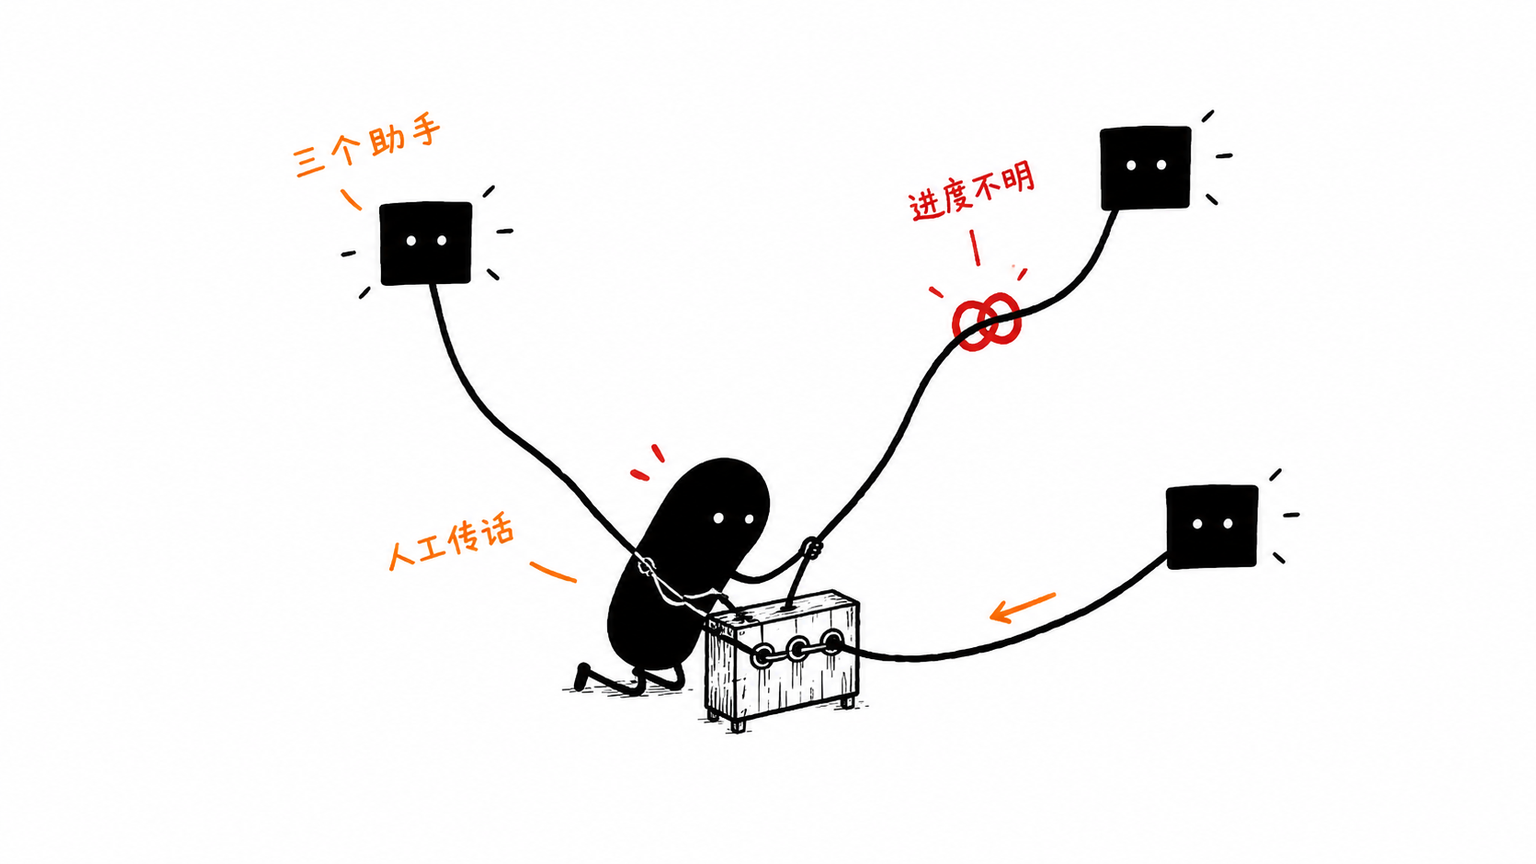
派活靠人肉。三个 agent 三个会话,你挨个复制粘贴指令。发完不知道对方看没看见,也不知道它理解对了没有。
等得心里没底。指令发出去了,对方是在认真跑,还是早挂了,没有地方能看。
结果散在三处。三份回复躺在三个会话里,汇总还得自己剪贴,来回切窗口。
失败的没人管。其中一个报错了,整个活就停在原地,得你人工发现、人工再喊一遍。
这五件事里,没有一件是真技术难题。它们全是流程问题:几个 agent 一起干活,缺一个负责拆活、派活、盯进度、收结果的角色。
根因:缺的是一层协作
拆开看,问题出在三个地方。
第一,agent 之间默认不互通。 这是设计使然,也是对的默认值:一个助手不该随便读别的会话。要协作就得显式开通,而开通这件事本身有点绕,两层配置加双向白名单,我见过不少人第一次配都要试几遍。
第二,派活没有标准动作。 跨会话发消息的机制是有的,但「发什么、怎么发、对方怎么回才算完成」没有约定,全靠临时发挥。指令写得含糊,对方就反问,来回几轮,一个任务变成一场对话。
第三,进度和结果没有归口。 谁在跑、跑到哪、成了没有,没有统一的地方能看;结论是谁给的、从哪来的,全靠自己记。
单个 agent 的能力已经不差了,缺的是把它们组织起来的那一层。
一件事把协作固定成流水线
动手之前先做了一轮生态调研,结论挺明确。
把 ClawHub 上 2400 个技能扫了一遍,多 agent 编排只有 compound-eng 系列,那是代码工程场景、从 EveryInc 移植过来的;框架级有几个,比如 metaswarm,做的是 Claude Code 的编码编排;Anthropic 官方那 19 个技能里,没有一个是协作类。
也就是说,「OpenClaw 日常协作编排」这块目前是空白带。而它刚好是一人公司最需要的那块:你手上有几个各有所长的 agent,缺的不是更强的单个助手,是把它们串起来干活的流程。
于是就有了这件东西:xiaoyaoclaw-agent-orchestrator(OpenClaw Agent Orchestrator,Agent 协作编排),十件套里的第七件,也是整套里的协作层。
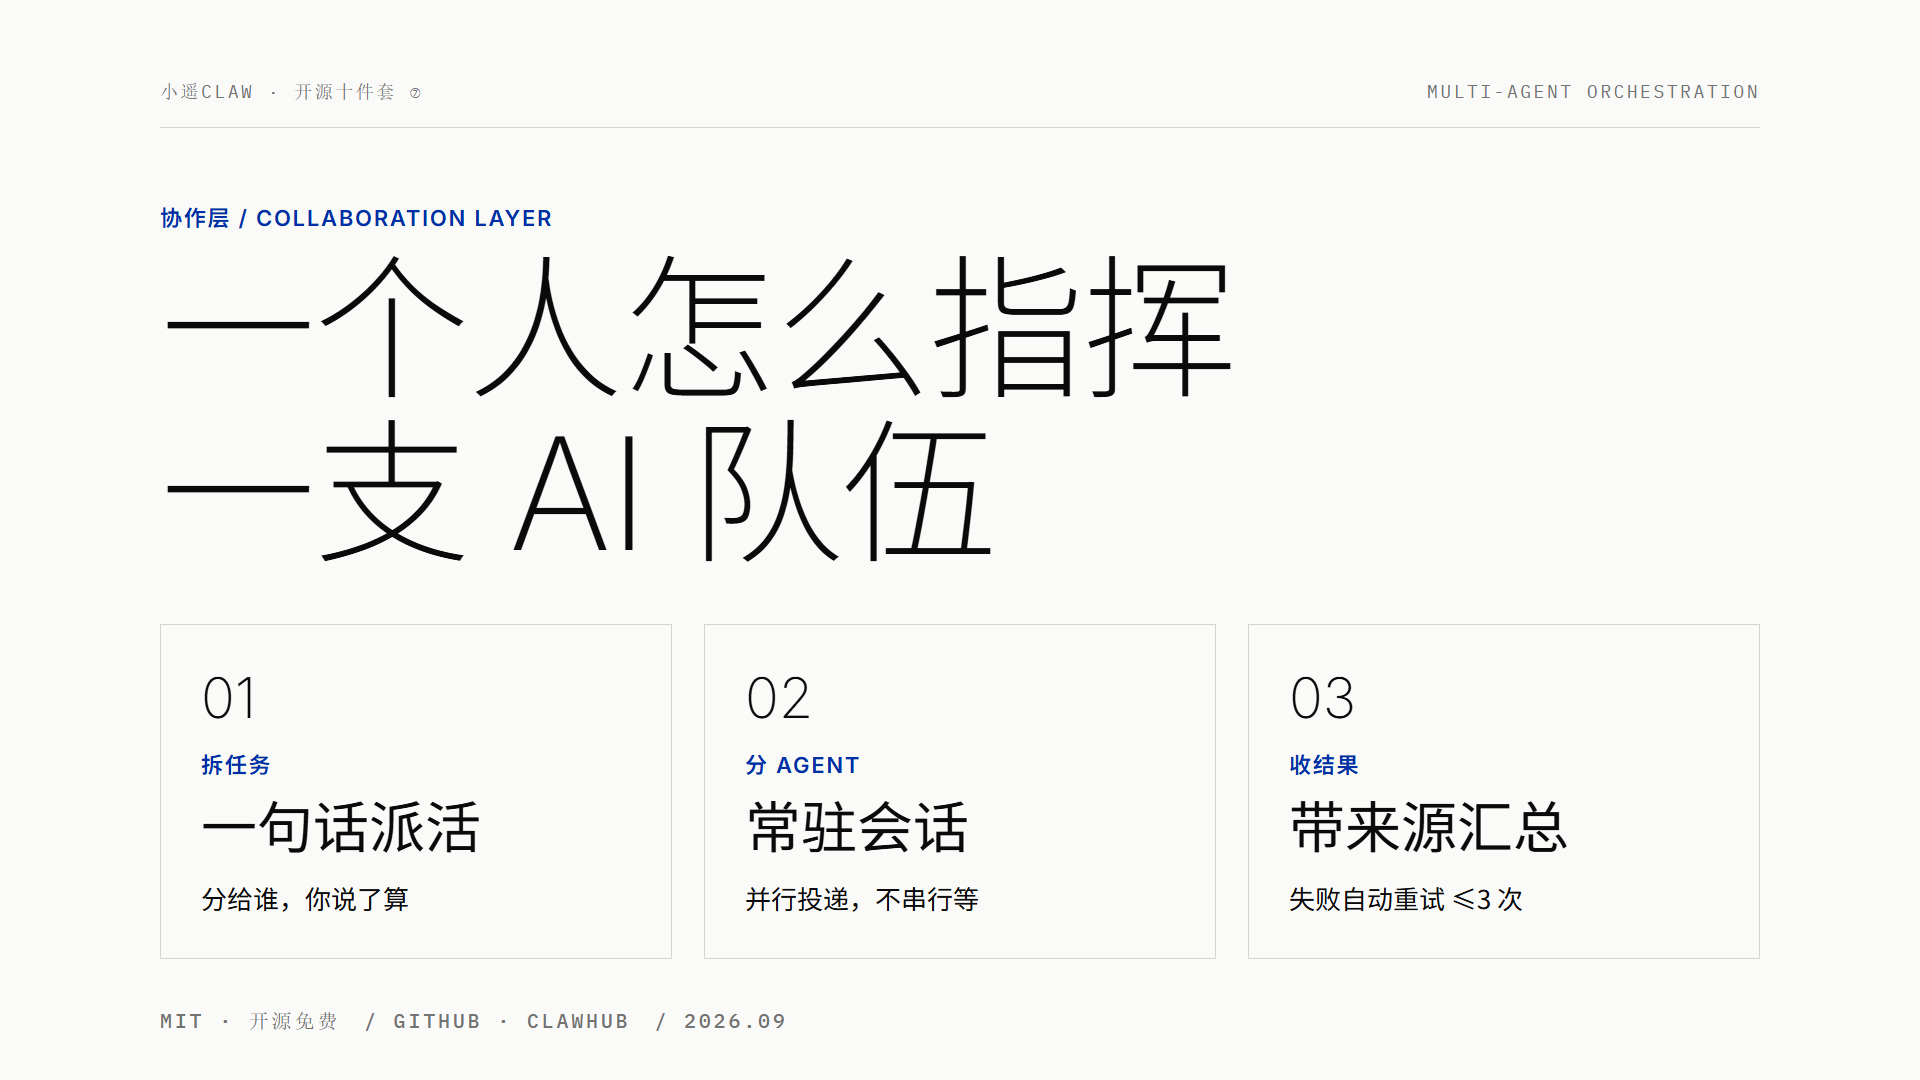
它做的事,一句话说完:把「拆任务 → 分 agent → 管进度 → 聚结果 → 失败重试」固定成一条流水线。你不用记命令,也不用写脚本,开口说一句「让小光画产品矩阵图,小智调研竞品,最后汇总成报告给我」就够了。
它不绑定任何环境,也不写死任何 agent 名字,读的是你 openclaw.json 里的 agents.list 和授权白名单。你的 agent 叫什么、能不能互相说话,配置文件里本来就写着,技能照着读,不额外维护一份名单。
关键设计①:走常驻会话,不临时招人
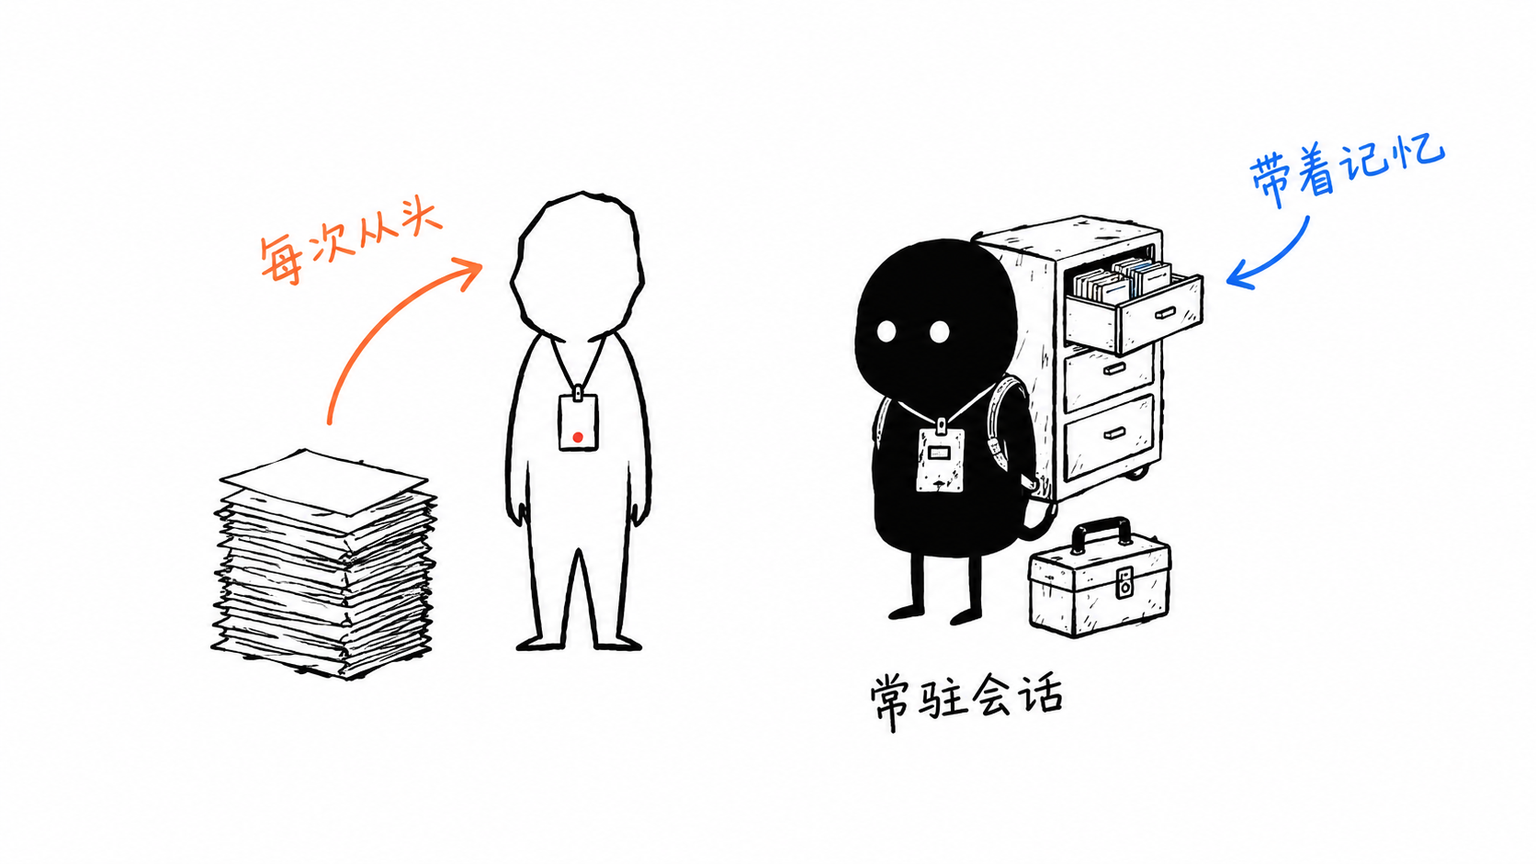
通信路径只留一条:sessions_send,把任务发到对方的常驻会话里。
另一种做法是临时开一个子会话去干活,两边的差别很实际。临时子会话没有前情、没有记忆、没有你早就配好的技能和人格,像临时招来的外包,每次都要从头交代背景。发到常驻会话,对方就是那个你养了很久的助手:记得你的偏好,带着自己的工具,能接上之前的工作。
这件东西要的是后面这种。
关键设计②:三档触发,从不抢活
不是所有任务都要编排。这件东西把触发分成三档:
第三档是最容易被忽略的一档,也是最要紧的一档。
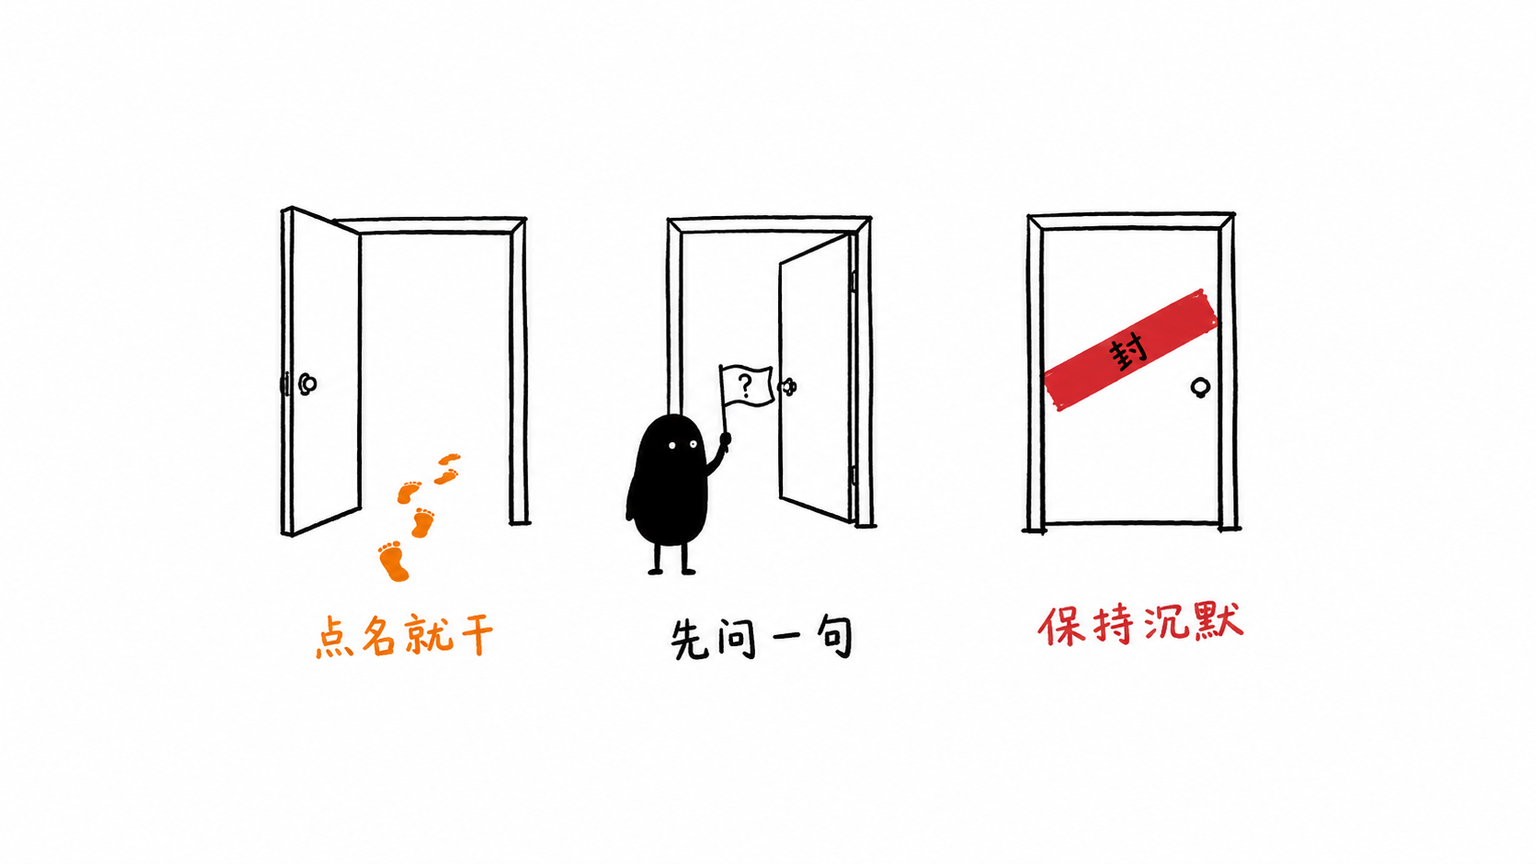
这个设计的教训来自十件套的第三件(任务进度跟踪器)。它最早的版本想做「任何任务都自动挂钩子」,结果是误报太多,天天打扰人。误报一多,这类自动化最后基本都会被关掉。所以这件从设计第一天就定死一条规矩:不确定就沉默,或者问一句,绝不擅自把活分出去。
关键设计③:进度用已有机制,不造轮子
进度这块有两个反直觉的点,都是实测踩出来的。
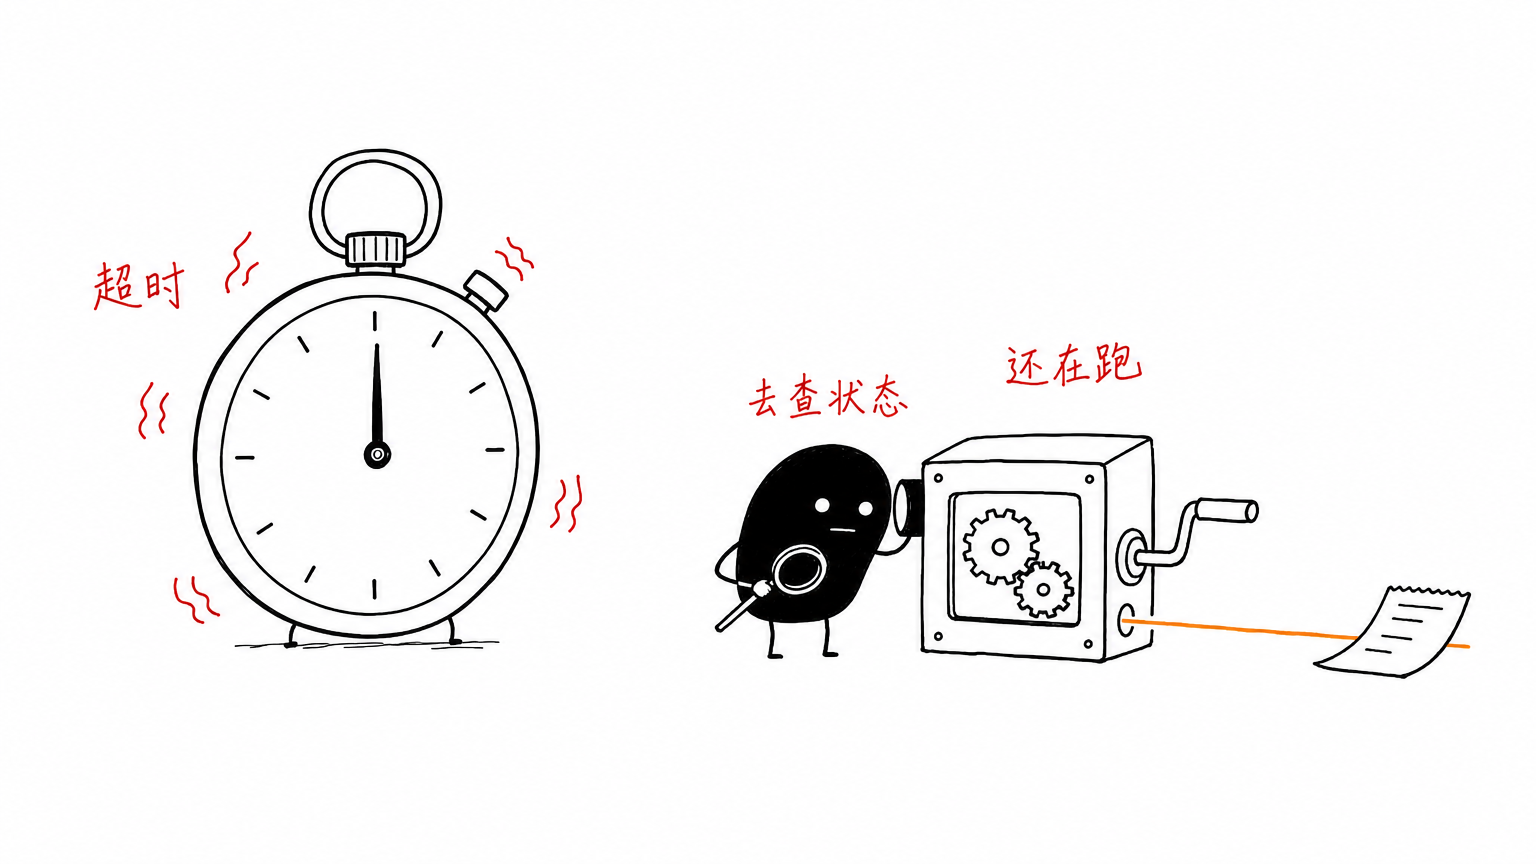
第一,60 秒超时不等于失败。 跨会话发消息默认等 60 秒,超时只说明「我没等到回复」,任务在对方那边继续跑着。很多人一看超时就以为任务挂了,重新发一遍,结果对方手上同时跑着两个一模一样的活。正确做法是去查真实状态:会话列表看它有没有在动,会话历史看有没有产出。
第二,分发不串行等。 几个子任务一次全发出去,发完立刻返回,最后总耗时约等于最慢的那个,而不是几个相加。发完统一进轮询,每隔半分钟到一分钟看一次状态。
轮询本身会消耗 token,所以配了一个零 token 的脚本,把各会话的状态一次性汇总出来。判断完成的依据也很直接:回复以 [DONE] 结尾算完成,有中间输出算在跑,明确报错或者长时间没产出算失败。至于「对方一直来回反问」这种死循环,指令模板里内置了「执行完一次性回复,不要追问」,OpenClaw 侧还有一个回复轮次上限做双保险。
关键设计④:汇总带来源,重试带上下文
最后两步,是把活收干净。
汇总带来源。 每个 agent 一段:任务、状态、结果摘要、产出文件在哪,并且标清楚哪条结论来自谁。往上追溯的时候,不会出现「这个数字谁说的、想不起来了」。
重试带上下文。 失败自动重试,默认最多 3 次。重试时会把上次失败的原因一起带上,同时告诉对方「已经做完的部分不要重做」,而不是把原指令原封不动再发一遍。3 次还是不行就停手,把失败原因和尝试记录一起交给你,不硬撑着刷。
它做的是「协作层」
十件套按层次看,前面六件各自解决一个环节:工作区、记忆、任务、知识库、体检、输入。这第七件架在它们之上,解决的是它们之间的配合。
它的编排流程是固定的八步:
① 触发判定(三档)→ ② 配置检查(双向白名单)
→ ③ 编排规划(拆子任务 + 匹配 agent + 给你确认)
→ ④ 并行分发(即发即返)→ ⑤ 进度追踪(会话列表 / 历史判定)
→ ⑥ 结果聚合(带来源)→ ⑦ 失败重试(≤3 次,带上下文)
→ ⑧ 交付(汇总 + 产出位置)
还有一个边界得讲明白:它不会偷偷改你的配置。配置不满足时它会先问「要不要帮你补」;你同意之后才动手,而且只用 config.patch 做部分合并,不做全量覆盖。原因很实际:多个 agent 共享同一份配置文件,全量覆盖会把别人刚改的东西抹掉。
三步上手
第一步:装,然后检测配置
clawhub install xiaoyaoclaw-agent-orchestrator
python scripts/check_config.py
输出 [OK] 就说明配置齐了。缺什么,脚本会直接告诉你缺哪一项、怎么补。也可以从 GitHub 手动装:git clone https://github.com/dtsola/xiaoyaoclaw-agent-orchestrator。
第二步:看有哪些 agent 可用
技能直接读 agents.list 展示,不用你另外登记。目前的主力是三个:小光(画图)、小智(调研)、天桐(技术)。
第三步:一句话派活
让小光把产品矩阵画出来,小智调研竞品,最后汇总成报告给我
接下来它会自动完成:检测配置 → 按名字找到对应会话 → 并行投递 → 追踪进度 → 收齐结果 → 输出带来源的汇总报告。
几个常见用法:
并行批量巡检:「让所有 agent 检查各自工作区」
发布前多视角审查:「让小智从用户视角审查这个页面,小光看视觉」
团队日报汇总:「汇总各 agent 今天的工作」
和手动做、自己写脚本比,差在哪
它不替你做判断,只是把你从传话和剪贴里摘出来。拆几个子任务、分给谁,还是你说了算。
写在最后
回到开头那个画面:一个人,三个助手,一个要协同才能完成的活。
人少的时候靠记忆和口头交代也能转,一旦手上同时开着几个活儿,没有流程就会乱。这件事在真人团队里早就被验证过了,换成 AI 助手,道理是一样的。
项目是 MIT 协议,开源免费,代码在 GitHub,也可以直接从 ClawHub 安装。如果你的电脑上已经不止一个 AI 助手,不妨试试给它们派个活,看看协作这一层补上之后是什么感觉。
小遥Claw:「把 AI 助手装进自己的电脑」,github:
github.com/dtsola/xiaoyaoclaw-introduction/releases/tag/v1.0.22
dtsola — 独立产品Builder | IT解决方案架构师 | 一人公司实践者
#OpenClaw #多Agent协作 #AI助手 #开源项目 #Agent编排 #自动化工作流 #一人公司 #AI工作流 #效率工具 #人工智能