收藏了,然后呢
刷到一篇好文章,读完觉得有用,手指点一下收藏,想着「以后再看」。这个动作我们每天都会做几次,熟练到不需要思考。
问题是,那个「以后」很少来。
打开浏览器的收藏夹,或者笔记软件的收藏列表,里面躺着几十上百条链接。标题都很眼熟,都是当初觉得「一定用得上」才存下来的。但真到要找资料的时候,我们不会去翻它。心里清楚,翻出来大概率也是一堆没整理过的、不知道当时为什么存的链接。
收藏这个动作,给人一种已经掌握了的错觉。点下按钮的那一刻,文章好像就成了自己的东西。它只是从一个列表,进了另一个列表。
收藏夹为什么会变成仓库
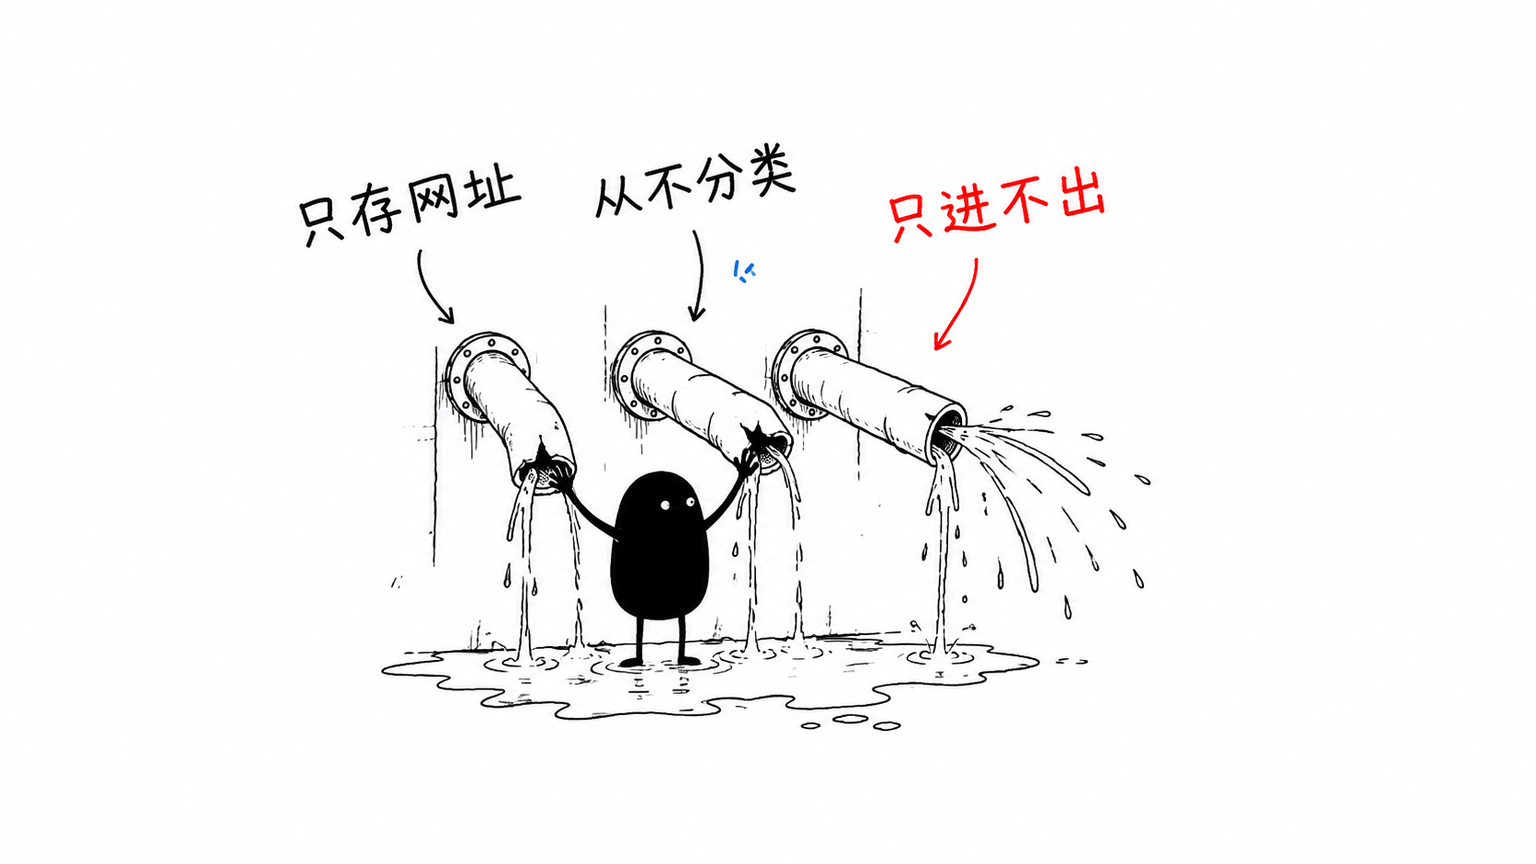
「收藏链接」这个动作本身有三个结构性问题,跟个人勤快不勤快没关系,谁用都会踩。
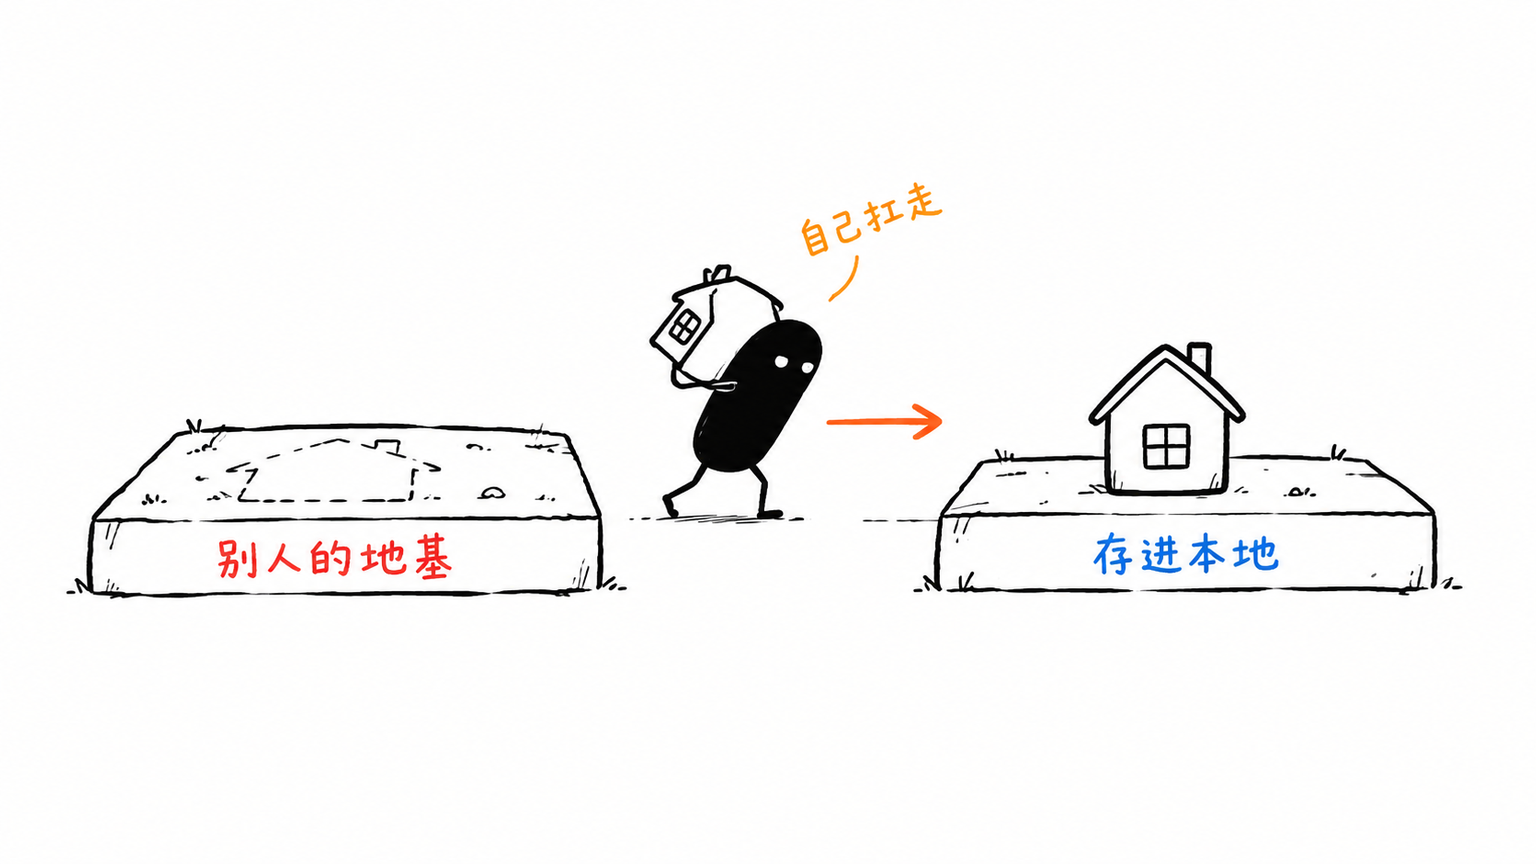
存下来的只是一个网址。 文章内容不在你手里,它活在别人的服务器上。对方改版、删文、关站,链接就死了。你收藏的时候它还好好的,三个月后点开,404。收藏了一堆网址,等于把家安在别人的地基上,地基什么时候塌,由不得你。
收藏时图快,从不分类。 收藏的一瞬间,人处在「这篇文章真好」的情绪里,想的是一键存下,不是整理归档。分类、打标签、写备注,这些动作要花时间,而收藏的本意就是省时间。于是所有链接堆在一起,日积月累,变成一锅粥。存的时候 1 秒,找的时候 10 分钟,还不一定找得到。
只进不出,没有再入口。 收藏夹只有一个入口,就是「收」。没有整理的习惯,没有定期回顾的机制,内容进去就沉底。它不是被读过的,只是被存放的。
三个问题叠在一起,收藏夹就变成了一座只进不出的仓库。仓库和图书馆的区别在于:图书馆有分类、有索引、随时能查到书;仓库只有货堆,东西在,但找不出来。
换个思路:收藏内容,而不是收藏链接
要打破这个循环,关键是把收藏的对象换掉:从收藏链接,变成收藏内容。
链接是借的,内容是自己的。把文章正文保存到本地,原文删了、链接挂了、网站关了,内容还在,而且还在你自己的机器上。想什么时候看就什么时候看,想怎么检索就怎么检索。
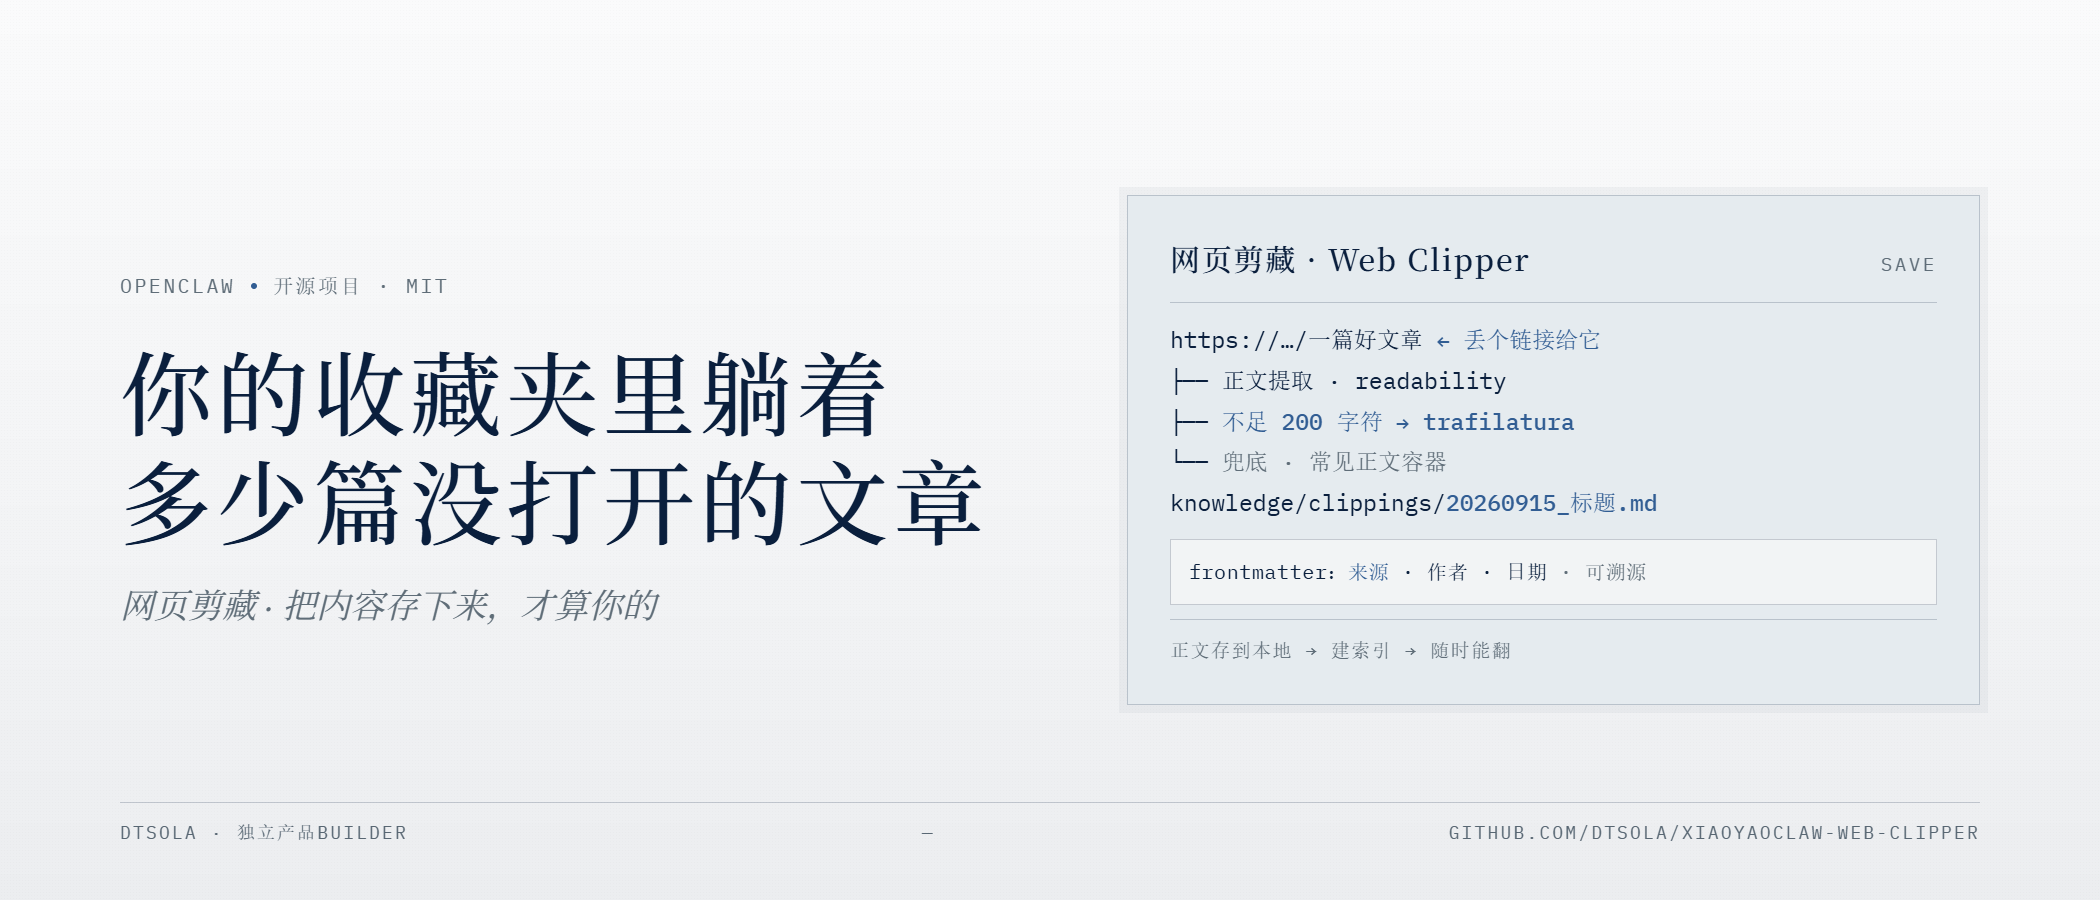
这就是今天要说的项目:xiaoyaoclaw-web-clipper(网页剪藏),我们开源「十件套」里的第六件。它的定位一句话能说清:网页的知识喂料机。给它一个链接,它把正文提取出来,存成一份带档案的本地 Markdown,直接进入知识库,之后随时可以检索。
三条设计底线
它有三条底线:
纯本地,数据不出机器。 剪藏是本地处理,不调用任何外部 API。文章内容从你机器上过一遍,存在你机器上,不会为了「云同步」之类的功能把内容送到别人的服务器。对经常剪藏敏感资料的人来说,这条很重要。
不假装成功。 有些网站反爬做得好,访问会返回 521、403 这类错误。遇到这种情况,它如实报告「这个站点抓不了」,建议你换浏览器或者换来源,而不是硬绕过去,或者吐给你一份残缺的正文假装完成了。提取质量不够,它会明说。
不绕过反爬。 它也不伪装成浏览器去骗过网站的防护。剪不到的站就是剪不到,如实告诉你,把精力留给能剪的源。
关键设计一:双引擎提取,剪不干净就换
网页转正文,看着简单,做起来全是坑。同一个网页里,导航、广告、推荐位、评论区,噪音比正文多得多。提取器稍微笨一点,存下来的就是一堆乱码加广告。
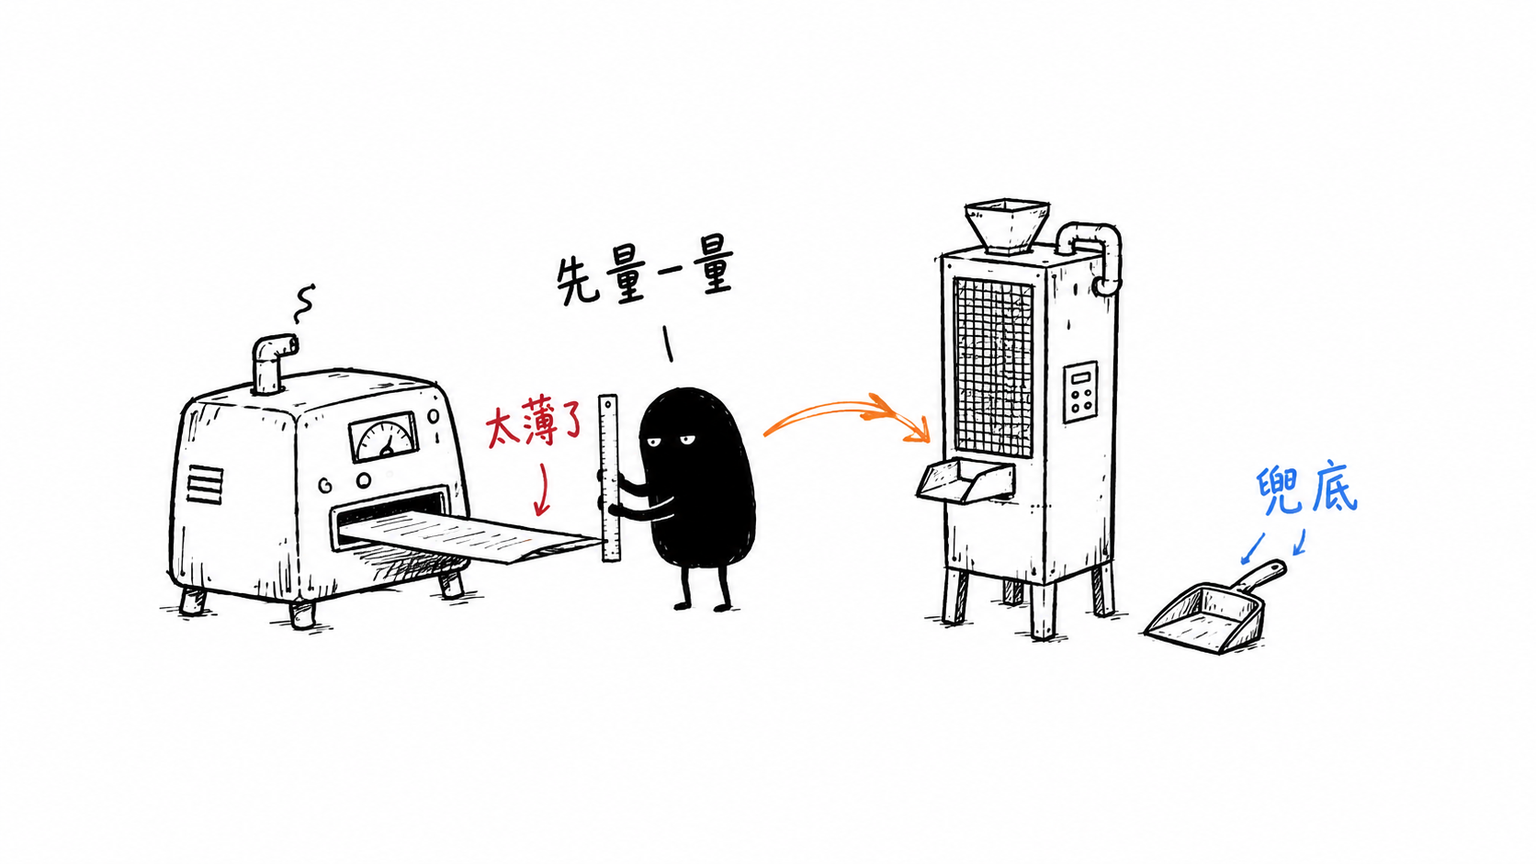
web-clipper 用的是双引擎降级链:
首选 readability-lxml,结构化好、速度快,适合绝大多数文章页;
如果提取出来的有效文本太短(判定标准:去掉噪音后不足 200 个字符),说明这个页面没提取干净,自动切换到 trafilatura,学术级的正文提取器;
还不行,就用兜底方案,按常见正文容器去抓。
每份剪藏文件里会记录这次用的是哪个引擎(frontmatter 里的 engine 字段),不藏着掖着。存下来的东西干不干净、用什么方式提取的,你都能看到。
关键设计二:中文网站,专门适配过
很多提取工具是外国人写的,对中文站点的结构不熟。微信公众号文章、知乎回答、CSDN 博客,各有各的页面结构,通用提取器经常抓歪。
web-clipper 对常见中文站点做了内置适配:微信公众号的正文容器、知乎的回答区、CSDN 的文章区,都直接认得。编码问题也处理了,GBK、UTF-8 自动判定,不会存出一堆乱码。
存下来的文件,档案是完整的。每份 Markdown 开头有一段 frontmatter,记录标题、原文链接、来源域名、作者、发布日期、剪藏时间。这意味着每份剪藏都可溯源:这段内容从哪来、谁写的、什么时候发的,清清楚楚。这一点比截图靠谱:截图六亲不认,只有像素,没有出处。
文件名也做了中文适配:20260908_文章标题.md 这样的格式,中文标题原样保留,只去掉非法字符,不会出现一串乱码文件名。
细节上的几件事:批量、去重、不删文件
批量剪藏。 攒了一批想存的文章,不用一条条发。把链接写进一个文本文件,每行一条,一次喂给它,它挨个处理。
自动去重。 它维护一个索引文件,剪藏过的链接会记下来。下次遇到重复的 URL,直接跳过,不浪费你的时间,也不会在目录里堆出好几份同样的文章。标题重复的,自动加序号区分。
不删任何文件。 包括它自己的去重索引,只追加、不删除。它对你机器上已有的东西,没有任何破坏能力。
三步上手
Step 1:安装
clawhub install xiaoyaoclaw-web-clipper或者从 GitHub 手动安装:git clone https://github.com/dtsola/xiaoyaoclaw-web-clipper,把 SKILL.md 和 scripts/ 放进你的 skills 目录。依赖很轻:核心只要 requests、beautifulsoup4、lxml 三个 Python 库;两个增强提取引擎(readability-lxml、trafilatura)是可选的,缺了自动降级,不影响基本使用。
Step 2:剪藏一篇文章
把链接发给它,或者本地跑一条命令:
python scripts/clip.py <文章链接>它提取正文,存成带档案的 Markdown,落到 knowledge/clippings/。
Step 3:建索引,让内容能被检索
跑一遍 kb-retriever 的建索引:
python <kb-retriever>/scripts/build_index.py <knowledge 根目录>之后就能像聊天一样检索这些剪藏内容了。
第三步是关键。剪藏如果只是存下来,那跟原来的收藏夹没有本质区别,还是只进不出。只有接上检索,存下来的东西才算真正被用起来:web-clipper 负责「喂」,kb-retriever 负责「翻」。这也呼应了第四篇那篇文章的标题:别让 AI 背资料库,让它翻资料库。资料先得进得来,才翻得到。
十件套里还有一个细节:workspace-auditor 做体检的时候,会专门检查 clippings/ 目录有没有建索引。没建索引的剪藏,在它眼里等于没入库。工具之间互相盯着,剪了没建索引,体检时会给你标出来。
写在最后
回到开头的收藏夹。我们收藏得并不少,只是存下来的都是会失效的链接,没有变成自己的内容。
链接躺三个月还是链接。内容存进本地知识库、建好索引,才是随时能调用的东西。如果你也有一堆「以后再看」的文章,不妨换一种存法。给 AI 助手发个链接,让它把内容留下来。
十件套里的其他成员,前面几篇陆续介绍过,这里把全家福再放一次:
项目是 MIT 协议,开源免费,代码在 GitHub,也可以从 ClawHub 一键安装。
下一次再看到好文章,别只点收藏。把内容留下来,它才算你的。
dtsola — 独立产品Builder | IT解决方案架构师 | 一人公司实践者
用户交流和反馈群
扫码加入【小遥 AI · 用户交流群】——产品反馈、使用交流、功能建议(用户专属)。
#网页剪藏 #开源项目 #AI编程 #知识工作者 #一人公司 #AI助手 #OpenClaw #知识管理 #AI创业 #效率工具